La mayor parte del software que podría ser útil nunca llega a construirse.
No porque sea técnicamente imposible, sino porque el problema es demasiado pequeño. Una herramienta para ordenar los datos de una migración, revisar un lote de contratos o coordinar una operación que durará dos semanas puede ahorrar muchas horas y, aun así, no justificar un proyecto de software. Diseñarla, desarrollarla, desplegarla y mantenerla cuesta más que convivir con varias hojas de cálculo.
La generación de código está moviendo ese límite. Cuando obtener una interfaz funcional deja de requerir semanas, aparecen aplicaciones que no necesitan convertirse en producto. Se crean para un objetivo, viven mientras ese objetivo existe y después se abandonan.
Se las empieza a llamar single-use apps, disposable apps o software efímero. El nombre todavía no está asentado. La pregunta que plantean sí es interesante: si crear software deja de ser la parte cara, ¿qué software merece seguir siendo permanente?
El software estaba obligado a durar
El desarrollo tradicional parte de una expectativa razonable: una aplicación debe utilizarse suficientes veces como para amortizar el esfuerzo de construirla.
Por eso los productos intentan cubrir muchos casos de uso. Añaden configuración, permisos, importadores, tutoriales y pantallas para públicos distintos. Esa generalidad permite repartir el coste entre miles de personas y varios años, pero obliga a cada usuario a adaptar su problema a la herramienta.
Una necesidad puntual queda fuera de esa economía. Si un equipo necesita una vista muy concreta durante una migración, suele elegir entre forzarla dentro de Excel, combinar varias herramientas o pedir un desarrollo interno que probablemente nunca llegue a ser prioritario.
Las aplicaciones de un solo uso invierten el cálculo. No preguntan cuántos años va a vivir el software, sino si el valor de resolver la tarea supera el coste de generarlo ahora. Tirar el resultado deja de ser un desperdicio cuando reconstruirlo cuesta menos que aprender, configurar y mantener una herramienta genérica.
En agosto de 2025, Anish Acharya utilizó la expresión disposable software para describir pequeñas aplicaciones personales que antes no habrían tenido sentido económico. No hablaba de código especialmente novedoso. La novedad era que una herramienta podía ser valiosa sin aspirar a escalar, monetizarse o sobrevivir.
Bajo el mismo nombre hay tres ideas diferentes
Parte de la confusión viene de llamar app generada a sistemas que funcionan de maneras muy distintas.
La versión más directa consiste en generar una aplicación convencional y desecharla después. Un modelo escribe el HTML, JavaScript o backend inicial. El resultado se puede ejecutar, inspeccionar y modificar como cualquier otro software. Su vida es corta por decisión, no porque carezca de código.
Un paso más allá está la interfaz generativa. En vez de responder siempre con texto o mostrar una pantalla diseñada de antemano, el sistema construye una visualización adecuada para la petición: una tabla, un simulador, un gráfico o una combinación de controles. Google presentó esta dirección como generative UI y empezó a probarla en Gemini y en el modo IA de Search mediante dynamic view a finales de 2025.
Aquí ya no se genera necesariamente un producto que alguien conservará. Se genera la mejor forma de interactuar con una respuesta.
La tercera versión es mucho más radical: el modelo representa el comportamiento de la aplicación mientras la persona la utiliza.
Anthropic exploró esta idea con Imagine with Claude. En aquella prueba no había una funcionalidad completa preparada antes de empezar. Claude construía el software en tiempo real y lo adaptaba a medida que llegaban interacciones. Parte de ese trabajo terminó reapareciendo en un formato más contenido: gráficos y visualizaciones interactivas creados dentro de una conversación.
Mirage, un prototipo de Daniel Mewes, elimina casi toda la aplicación. El modelo genera el HTML de una pantalla y, cuando alguien pulsa un botón, recibe la interacción y produce la pantalla siguiente. No existe una lógica de negocio persistente que determine la transición. El modelo imagina qué debería ocurrir.
Los tres enfoques pueden parecer iguales en una demostración. Técnicamente no lo son. En el primero se genera software. En el segundo se genera una interfaz sobre ciertas capacidades. En el tercero, el modelo intenta ser el software.
Un caso donde la idea sí tiene sentido
Pensemos en una migración de infraestructura. Durante unos días, el equipo necesita cruzar un inventario cloud, una exportación de costes y una lista de responsables. Debe localizar recursos sin propietario, agrupar dependencias y producir un plan de acciones.
Una aplicación permanente para ese proceso tendría que soportar futuros proveedores, esquemas de datos distintos y multitud de excepciones. Sería un producto considerable. Pero la operación actual está acotada: hay tres fuentes conocidas, un equipo pequeño y un entregable claro.
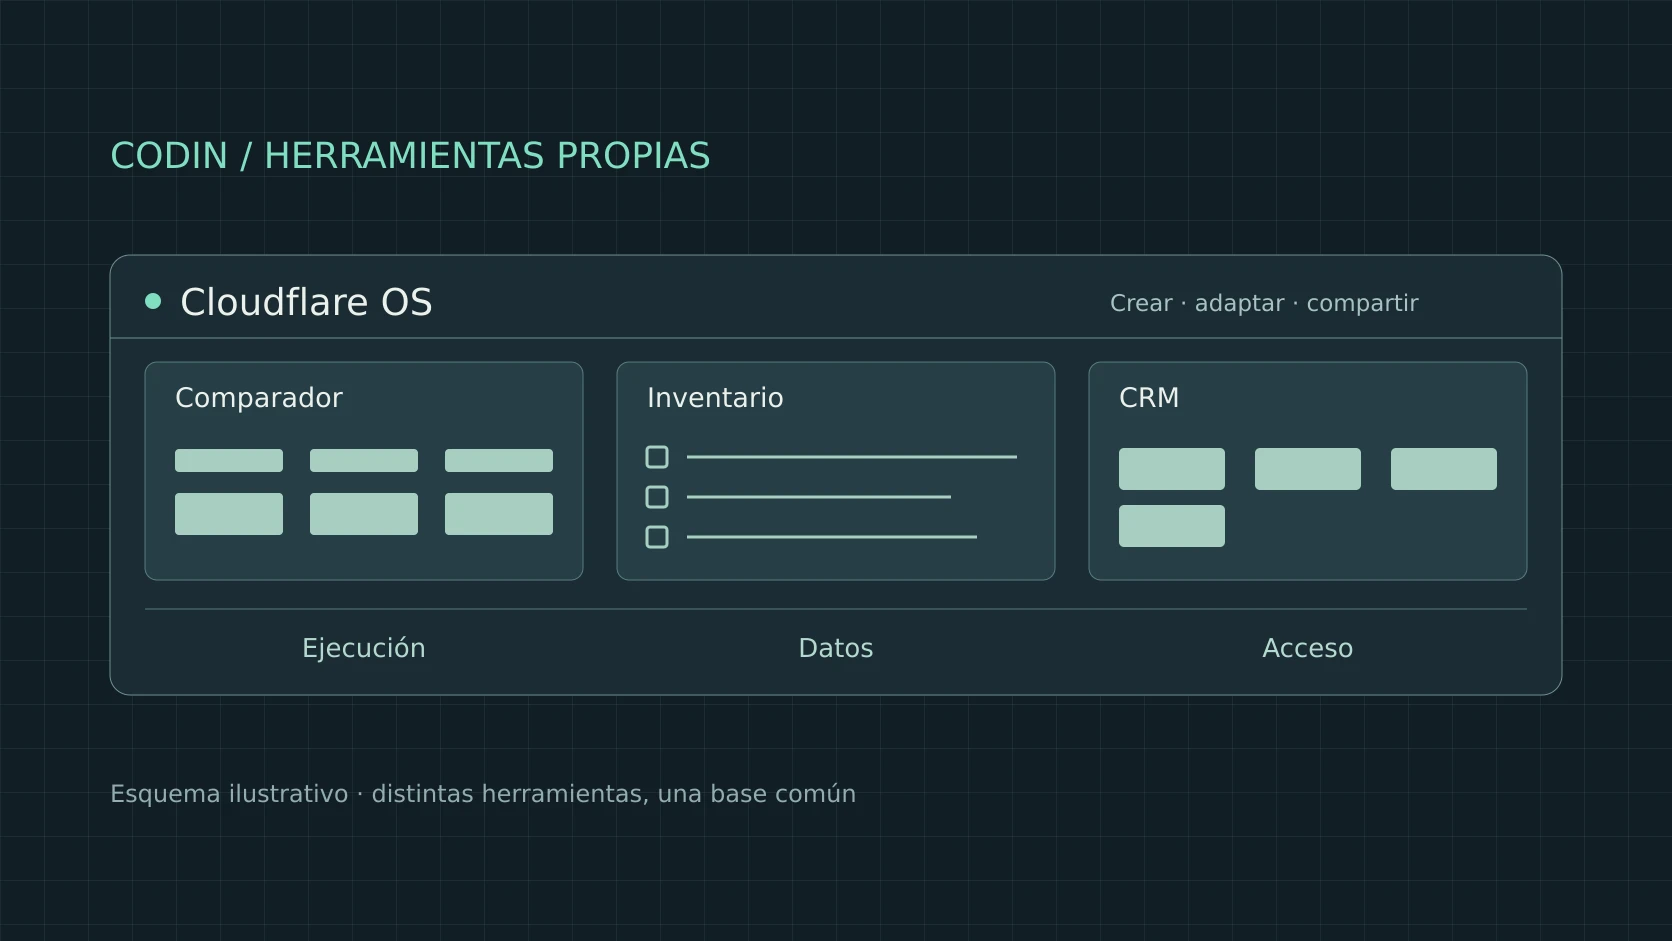
Una single-use app podría generar un espacio de revisión para ese conjunto de datos, ofrecer filtros específicos y exportar el plan final. Cuando termina la migración, la interfaz deja de ser útil. El inventario corregido, las decisiones y el registro de cambios no.
Esa diferencia es la clave. La aplicación puede ser temporal; la verdad que manipula no debería serlo.
El patrón encaja cuando la tarea tiene principio y final, los datos están controlados, los errores son detectables y existe un resultado que puede conservarse fuera de la herramienta. No encaja igual de bien cuando el propio programa debe ser el sistema de registro, coordinar a cientos de usuarios o ejecutar acciones difíciles de revertir.
La arquitectura más plausible no es una app alucinada
La versión más sólida de esta idea separa una capa duradera de otra temporal:
objetivo + contexto
        ↓
interfaz generada para la tarea
        ↓
acciones y componentes permitidos
        ↓
APIs, reglas y datos duraderos
El modelo decide qué información conviene mostrar y qué controles ayudan en ese momento. No decide por sí solo cómo se calcula una factura, quién puede aprobar un pago o dónde se guarda el historial. Esas responsabilidades permanecen en servicios convencionales.
Podríamos llamarlo núcleo estable, interfaz desechable.
Esta separación resuelve varios problemas a la vez. Los datos sobreviven a la sesión. Los permisos no dependen del prompt. Las acciones importantes pueden validarse y registrarse. La interfaz cambia sin obligar a regenerar el sistema que contiene la verdad.
También explica por qué los enfoques declarativos están ganando interés. A2UI, presentado por Google como proyecto abierto en diciembre de 2025, permite que un agente describa una interfaz mediante datos estructurados. La aplicación anfitriona traduce esa descripción a componentes que ya conoce.
El modelo puede pedir una tabla, un selector o un formulario, pero no necesita enviar JavaScript arbitrario. El producto conserva el control sobre el diseño, la accesibilidad y las acciones disponibles. Es menos libre que generar cualquier código, pero esa limitación es precisamente lo que lo vuelve más razonable para producción.
El problema difícil no es dibujar la pantalla
Una demostración de interfaz generativa suele concentrarse en el instante en que aparece algo visual. Es la parte más fácil de enseñar y la que produce mayor sensación de novedad. Pero no es donde se acumula el riesgo.
El coste importante empieza cuando la interfaz debe hacer algo real:
- mantener estado entre sesiones;
- distinguir usuarios y permisos;
- producir el mismo cálculo ante los mismos datos;
- sobrevivir a un fallo del modelo;
- explicar qué acción se ejecutó y por qué;
- permitir deshacer o recuperar información;
- seguir siendo accesible y comprensible aunque cambie.
Un contexto de conversación no sustituye a una base de datos. Una predicción plausible no sustituye a una transición de estado. Una pantalla convincente no demuestra que el dato mostrado proceda de la fuente correcta.
Mirage hace visibles estas limitaciones porque no intenta ocultarlas. El propio prototipo pierde sus datos al cerrar la sesión, puede modificar información inesperadamente y termina fallando cuando se llena el contexto. Como experimento es útil: muestra hasta dónde puede simular software un modelo. Como arquitectura también muestra por qué simularlo no basta.
La generación reduce el coste de la primera versión. La confianza, la integración y la operación siguen teniendo un coste distinto.
Lo que probablemente veremos primero
El cambio más cercano no será la desaparición de las aplicaciones. Será la desaparición de algunas de sus pantallas fijas.
Los productos con datos y APIs valiosos podrán construir vistas distintas según la tarea. Un sistema financiero puede mantener intactos su libro mayor y sus permisos mientras genera una superficie específica para investigar una desviación. Una plataforma de operaciones puede reunir en una sola vista los controles necesarios para resolver una incidencia concreta y retirar esa vista cuando se cierre.
También crecerá el software para la larga cola interna: reconciliaciones, migraciones, revisiones y procesos temporales que nunca justificaron entrar en el roadmap. No reemplazarán los sistemas principales. Se apoyarán en ellos para resolver el tramo particular que hoy termina en una hoja de cálculo.
Algunas de estas herramientas nacerán con caducidad explícita. Al terminar el proyecto se revocarán sus credenciales, se archivará el resultado y se eliminará el despliegue. Que el software sea temporal tendrá que incluir su infraestructura y sus accesos, no solo abandonar un repositorio.
Y el trabajo de producto cambiará de lugar. En vez de diseñar únicamente pantallas, habrá que diseñar el espacio dentro del que el modelo puede componerlas: qué componentes existen, qué acciones están permitidas, qué datos son fiables y qué estados nunca deben generarse.
Lo permanente seguirá teniendo valor
Una interfaz estable crea memoria. Después de utilizarla varias veces sabemos dónde está cada función, qué ocurrirá al pulsarla y cómo explicar el proceso a otra persona. Esa previsibilidad es valiosa en tareas frecuentes y críticas.
Generar una experiencia distinta en cada sesión también tiene costes. Introduce latencia, dificulta el soporte y multiplica las combinaciones que habría que comprobar. A veces el mejor formulario es el mismo formulario de siempre, porque millones de personas ya entienden cómo funciona.
Las single-use apps no anuncian el final del software mantenido. Amplían el territorio en el que merece la pena construir algo. Permiten dar una interfaz propia a problemas demasiado pequeños, breves o específicos para convertirse en producto.
La web organizó buena parte del software alrededor de páginas. El móvil lo organizó alrededor de aplicaciones. La interfaz generativa propone organizar una parte alrededor de intenciones: primero aparece la necesidad y después la forma de interactuar con ella.
Debajo seguirán haciendo falta sistemas que no improvisen. La cuestión no es elegir entre software permanente o desechable, sino decidir con precisión qué debe recordar el sistema cuando la interfaz ya no exista.
Fuentes
- Anish Acharya: Disposable Software
- Anthropic: presentación de Imagine with Claude
- Anthropic: visualizaciones interactivas dentro de Claude
- Google Research: Generative UI
- Google Developers: presentación del proyecto A2UI
- Google Cloud: enfoques para construir interfaces generativas
- Daniel Mewes: Mirage, una aplicación alucinada pantalla a pantalla