La plupart des logiciels qui pourraient être utiles ne sont jamais construits.
Non pas parce qu’ils seraient techniquement impossibles, mais parce que le problème est trop petit. Un outil destiné à organiser les données d’une migration, à examiner un lot de contrats ou à coordonner une opération de deux semaines peut faire gagner de nombreuses heures sans pour autant justifier un projet logiciel. Le concevoir, le développer, le déployer et le maintenir coûte plus cher que de composer avec plusieurs feuilles de calcul.
La génération de code déplace cette limite. Lorsqu’obtenir une interface fonctionnelle ne demande plus des semaines, des applications peuvent voir le jour sans devoir devenir des produits. Elles sont créées pour un objectif, vivent tant que cet objectif existe, puis sont abandonnées.
On commence à les appeler single-use apps, disposable apps ou logiciels éphémères. Le nom n’est pas encore fixé. La question qu’elles soulèvent, elle, est intéressante : si créer un logiciel cesse d’être la partie coûteuse, quels logiciels méritent encore d’être permanents ?
Le logiciel était condamné à durer
Le développement traditionnel part d’une attente raisonnable : une application doit être utilisée suffisamment de fois pour amortir l’effort nécessaire à sa construction.
C’est pourquoi les produits cherchent à couvrir de nombreux cas d’usage. Ils ajoutent de la configuration, des permissions, des outils d’import, des tutoriels et des écrans pour différents publics. Cette généralité permet de répartir le coût entre des milliers de personnes et sur plusieurs années, mais elle oblige chaque utilisateur à adapter son problème à l’outil.
Un besoin ponctuel échappe à cette économie. Si une équipe a besoin d’une vue très précise pendant une migration, elle doit généralement la forcer dans Excel, combiner plusieurs outils ou demander un développement interne qui ne deviendra probablement jamais prioritaire.
Les applications à usage unique inversent le calcul. Elles ne demandent pas combien d’années le logiciel vivra, mais si la valeur apportée par la résolution de la tâche dépasse le coût de sa génération immédiate. Jeter le résultat n’est plus un gaspillage lorsque le reconstruire coûte moins cher que d’apprendre, de configurer et de maintenir un outil générique.
En août 2025, Anish Acharya a utilisé l’expression disposable software pour décrire de petites applications personnelles qui, auparavant, n’auraient eu aucun sens économique. Il ne parlait pas d’un code particulièrement novateur. La nouveauté résidait dans le fait qu’un outil pouvait avoir de la valeur sans chercher à passer à l’échelle, à être monétisé ou à survivre.
Un même nom recouvre trois idées différentes
Une partie de la confusion vient de l’expression application générée, appliquée à des systèmes qui fonctionnent de manières très différentes.
La version la plus directe consiste à générer une application conventionnelle, puis à la jeter. Un modèle écrit le HTML, le JavaScript ou le backend initial. Le résultat peut être exécuté, inspecté et modifié comme n’importe quel autre logiciel. Sa durée de vie est courte par choix, non parce qu’il serait dépourvu de code.
L’étape suivante est celle de l’interface générative. Au lieu de toujours répondre par du texte ou d’afficher un écran conçu à l’avance, le système construit une visualisation adaptée à la demande : un tableau, un simulateur, un graphique ou un ensemble de contrôles. Google a présenté cette direction sous le nom de generative UI et a commencé à la tester dans Gemini et dans le mode IA de Search au moyen de dynamic view, fin 2025.
Ici, le système ne génère pas nécessairement un produit que quelqu’un conservera. Il génère la meilleure manière d’interagir avec une réponse.
La troisième version est bien plus radicale : le modèle incarne le comportement de l’application pendant que la personne l’utilise.
Anthropic a exploré cette idée avec Imagine with Claude. Dans cette expérimentation, aucune fonctionnalité complète n’était préparée avant le début de l’interaction. Claude construisait le logiciel en temps réel et l’adaptait à mesure que de nouvelles interactions survenaient. Une partie de ce travail est ensuite réapparue dans un format plus encadré : des graphiques et visualisations interactives créés au sein d’une conversation.
Mirage, un prototype de Daniel Mewes, supprime presque toute l’application. Le modèle génère le HTML d’un écran et, lorsqu’une personne clique sur un bouton, reçoit l’interaction et produit l’écran suivant. Aucune logique métier persistante ne détermine la transition. Le modèle imagine ce qui devrait se passer.
Les trois approches peuvent sembler identiques lors d’une démonstration. Techniquement, elles ne le sont pas. Dans la première, on génère un logiciel. Dans la deuxième, on génère une interface au-dessus de certaines capacités. Dans la troisième, le modèle tente d’être le logiciel.
Un cas où l’idée a réellement du sens
Prenons une migration d’infrastructure. Pendant quelques jours, l’équipe doit croiser un inventaire cloud, un export de coûts et une liste de responsables. Elle doit repérer les ressources sans propriétaire, regrouper les dépendances et produire un plan d’action.
Une application permanente dédiée à ce processus devrait prendre en charge de futurs fournisseurs, différents schémas de données et une multitude d’exceptions. Ce serait un produit conséquent. Mais l’opération actuelle est délimitée : trois sources connues, une petite équipe et un livrable clair.
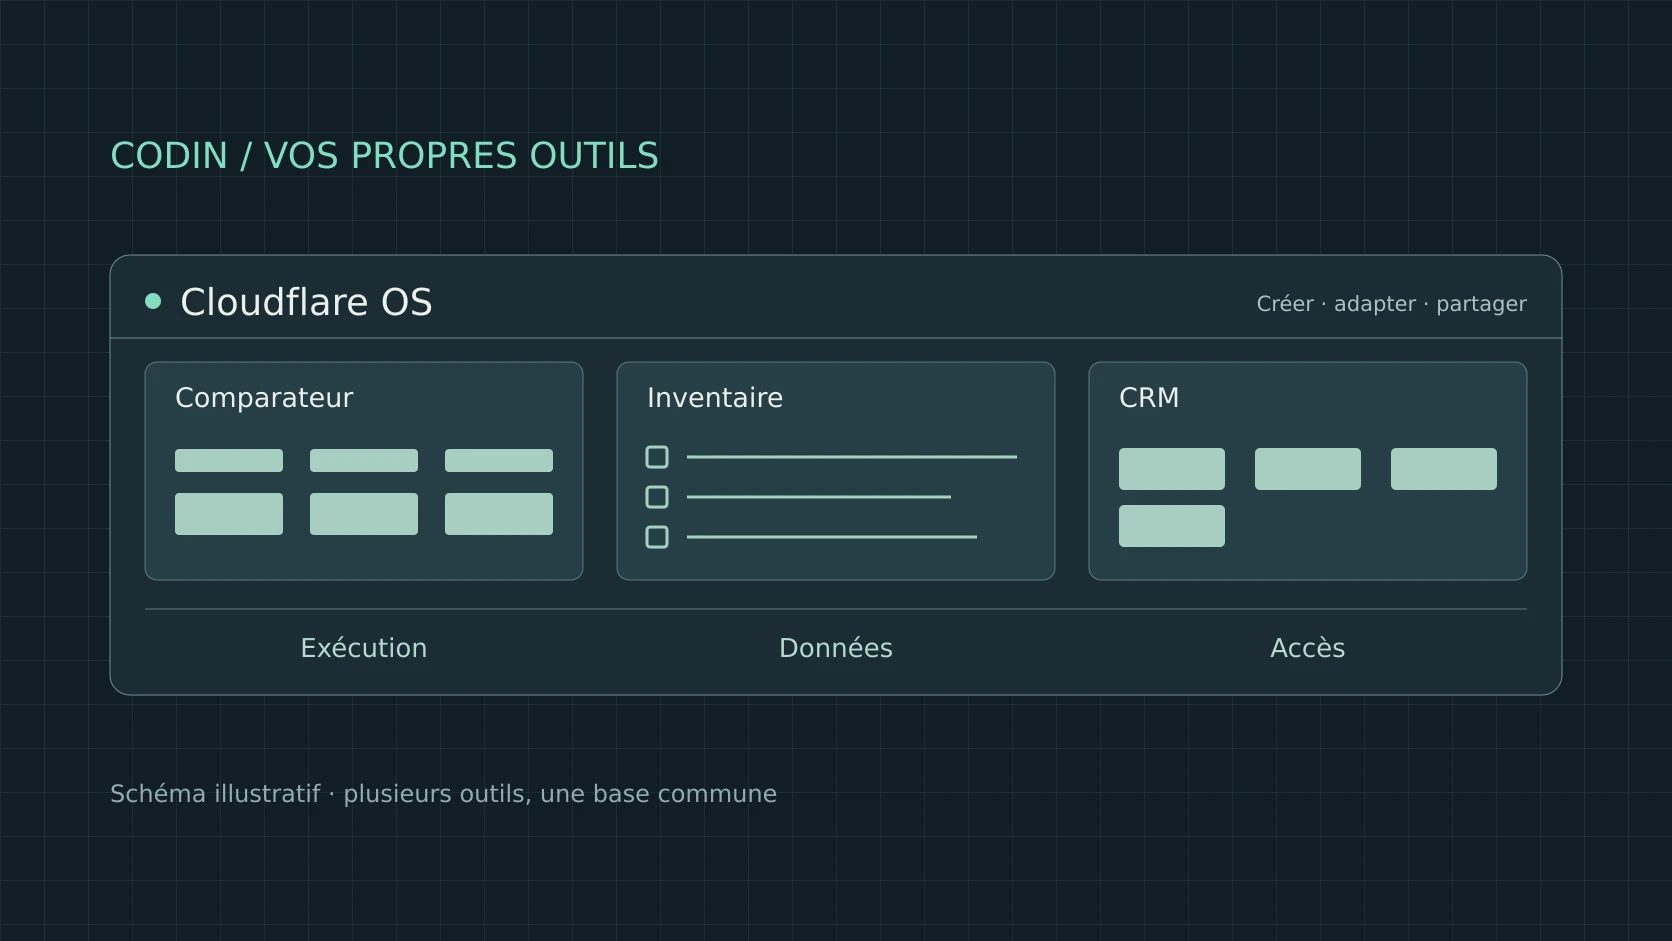
Une single-use app pourrait créer un espace de révision pour ce jeu de données, proposer des filtres spécifiques et exporter le plan final. Une fois la migration terminée, l’interface ne sert plus. L’inventaire corrigé, les décisions et le journal des modifications, eux, restent utiles.
Cette différence est essentielle. L’application peut être temporaire ; la vérité qu’elle manipule ne devrait pas l’être.
Le modèle convient lorsque la tâche a un début et une fin, que les données sont contrôlées, que les erreurs sont détectables et qu’un résultat peut être conservé hors de l’outil. Il convient moins bien lorsque le programme lui-même doit être le système de référence, coordonner des centaines d’utilisateurs ou exécuter des actions difficiles à annuler.
L’architecture la plus plausible n’est pas une application hallucinée
La version la plus solide de cette idée sépare une couche durable d’une couche temporaire :
objectif + contexte
        ↓
interface générée pour la tâche
        ↓
actions et composants autorisés
        ↓
API, règles et données durables
Le modèle décide quelles informations il est utile d’afficher et quels contrôles peuvent aider à cet instant. Il ne décide pas seul du calcul d’une facture, de la personne autorisée à approuver un paiement ou du lieu de conservation de l’historique. Ces responsabilités restent confiées à des services conventionnels.
On pourrait parler de noyau stable et d’interface jetable.
Cette séparation résout plusieurs problèmes à la fois. Les données survivent à la session. Les permissions ne dépendent pas du prompt. Les actions importantes peuvent être validées et enregistrées. L’interface peut changer sans qu’il soit nécessaire de régénérer le système qui contient la vérité.
Elle explique aussi l’intérêt croissant pour les approches déclaratives. A2UI, présenté par Google comme projet ouvert en décembre 2025, permet à un agent de décrire une interface au moyen de données structurées. L’application hôte traduit cette description en composants qu’elle connaît déjà.
Le modèle peut demander un tableau, un sélecteur ou un formulaire sans avoir à envoyer du JavaScript arbitraire. Le produit conserve la maîtrise du design, de l’accessibilité et des actions disponibles. Cette approche est moins libre que la génération de n’importe quel code, mais cette contrainte est précisément ce qui la rend plus raisonnable en production.
Le problème difficile n’est pas de dessiner l’écran
Une démonstration d’interface générative se concentre généralement sur l’instant où un élément visuel apparaît. C’est la partie la plus facile à montrer et celle qui procure la plus forte impression de nouveauté. Mais ce n’est pas là que le risque s’accumule.
Le coût important apparaît lorsque l’interface doit accomplir quelque chose de réel :
- conserver l’état entre les sessions ;
- distinguer les utilisateurs et leurs permissions ;
- produire le même calcul à partir des mêmes données ;
- résister à une défaillance du modèle ;
- expliquer quelle action a été exécutée et pourquoi ;
- permettre d’annuler une opération ou de récupérer des informations ;
- rester accessible et compréhensible même lorsqu’elle change.
Un contexte de conversation n’est pas une base de données. Une prédiction plausible n’est pas une transition d’état. Un écran convaincant ne prouve pas que les données affichées proviennent de la bonne source.
Mirage rend ces limites visibles parce qu’il ne cherche pas à les masquer. Le prototype perd ses données à la fermeture de la session, peut modifier des informations de manière inattendue et finit par tomber en panne lorsque le contexte est saturé. Comme expérimentation, il est utile : il montre jusqu’où un modèle peut simuler un logiciel. Comme architecture, il montre aussi pourquoi le simuler ne suffit pas.
La génération réduit le coût de la première version. La confiance, l’intégration et l’exploitation conservent un coût d’une autre nature.
Ce que nous verrons probablement en premier
Le changement le plus proche ne sera pas la disparition des applications. Ce sera celle de certains de leurs écrans fixes.
Les produits qui possèdent des données et des API de valeur pourront construire des vues différentes en fonction de la tâche. Un système financier pourra conserver intacts son grand livre et ses permissions tout en générant une surface spécifique pour analyser un écart. Une plateforme d’opérations pourra réunir dans une seule vue les contrôles nécessaires à la résolution d’un incident précis, puis retirer cette vue une fois l’incident clos.
Les logiciels destinés à la longue traîne interne vont également se développer : rapprochements, migrations, vérifications et processus temporaires qui n’ont jamais justifié une place dans la roadmap. Ils ne remplaceront pas les systèmes principaux. Ils s’appuieront sur eux pour résoudre la partie précise qui finit aujourd’hui dans une feuille de calcul.
Certains de ces outils naîtront avec une date d’expiration explicite. À la fin du projet, leurs identifiants seront révoqués, le résultat archivé et le déploiement supprimé. Pour qu’un logiciel soit temporaire, son infrastructure et ses accès devront l’être également — il ne suffira pas d’abandonner un dépôt.
Le travail produit se déplacera lui aussi. Au lieu de concevoir uniquement des écrans, il faudra concevoir l’espace dans lequel le modèle peut les composer : quels composants existent, quelles actions sont autorisées, quelles données sont fiables et quels états ne doivent jamais être générés.
Ce qui est permanent conservera sa valeur
Une interface stable crée une mémoire. Après l’avoir utilisée plusieurs fois, nous savons où se trouve chaque fonction, ce qui se passera lorsque nous cliquerons et comment expliquer le processus à quelqu’un d’autre. Cette prévisibilité est précieuse pour les tâches fréquentes et critiques.
Générer une expérience différente à chaque session a également un coût. Cela introduit de la latence, complique le support et multiplie les combinaisons à tester. Parfois, le meilleur formulaire est le bon vieux formulaire, parce que des millions de personnes savent déjà comment il fonctionne.
Les single-use apps n’annoncent pas la fin des logiciels maintenus. Elles élargissent le territoire dans lequel il vaut la peine de construire quelque chose. Elles permettent d’offrir une interface dédiée à des problèmes trop petits, trop brefs ou trop spécifiques pour devenir un produit.
Le web a organisé une grande partie du logiciel autour des pages. Le mobile l’a organisé autour des applications. L’interface générative propose d’en organiser une partie autour des intentions : le besoin apparaît d’abord, puis la manière d’interagir avec lui.
En dessous, nous aurons toujours besoin de systèmes qui n’improvisent pas. La question n’est pas de choisir entre un logiciel permanent ou jetable, mais de décider précisément ce que le système doit retenir lorsque l’interface n’existe plus.
Sources
- Anish Acharya : Disposable Software
- Anthropic : présentation d’Imagine with Claude
- Anthropic : visualisations interactives dans Claude
- Google Research : Generative UI
- Google Developers : présentation du projet A2UI
- Google Cloud : approches pour construire des interfaces génératives
- Daniel Mewes : Mirage, une application hallucinée écran après écran